Las herramientas HUM.05 · HUM△NS
Verlo en vivo

TDI / HUM.05 · simula · Los cuatro instrumentos

HUM△NS™

Prueba tu concepto y tu precio antes de pagar el campo.

Antes de pagar investigación de campo, focus groups o una nueva ejecución, HUM△NS permite someter una idea a perfiles construidos sobre la encuesta de consumidores: un concepto, una etiqueta, un precio, una ocasión de consumo. No sustituye a una persona real. Sirve para descartar hipótesis débiles antes de gastar en comprobarlas.

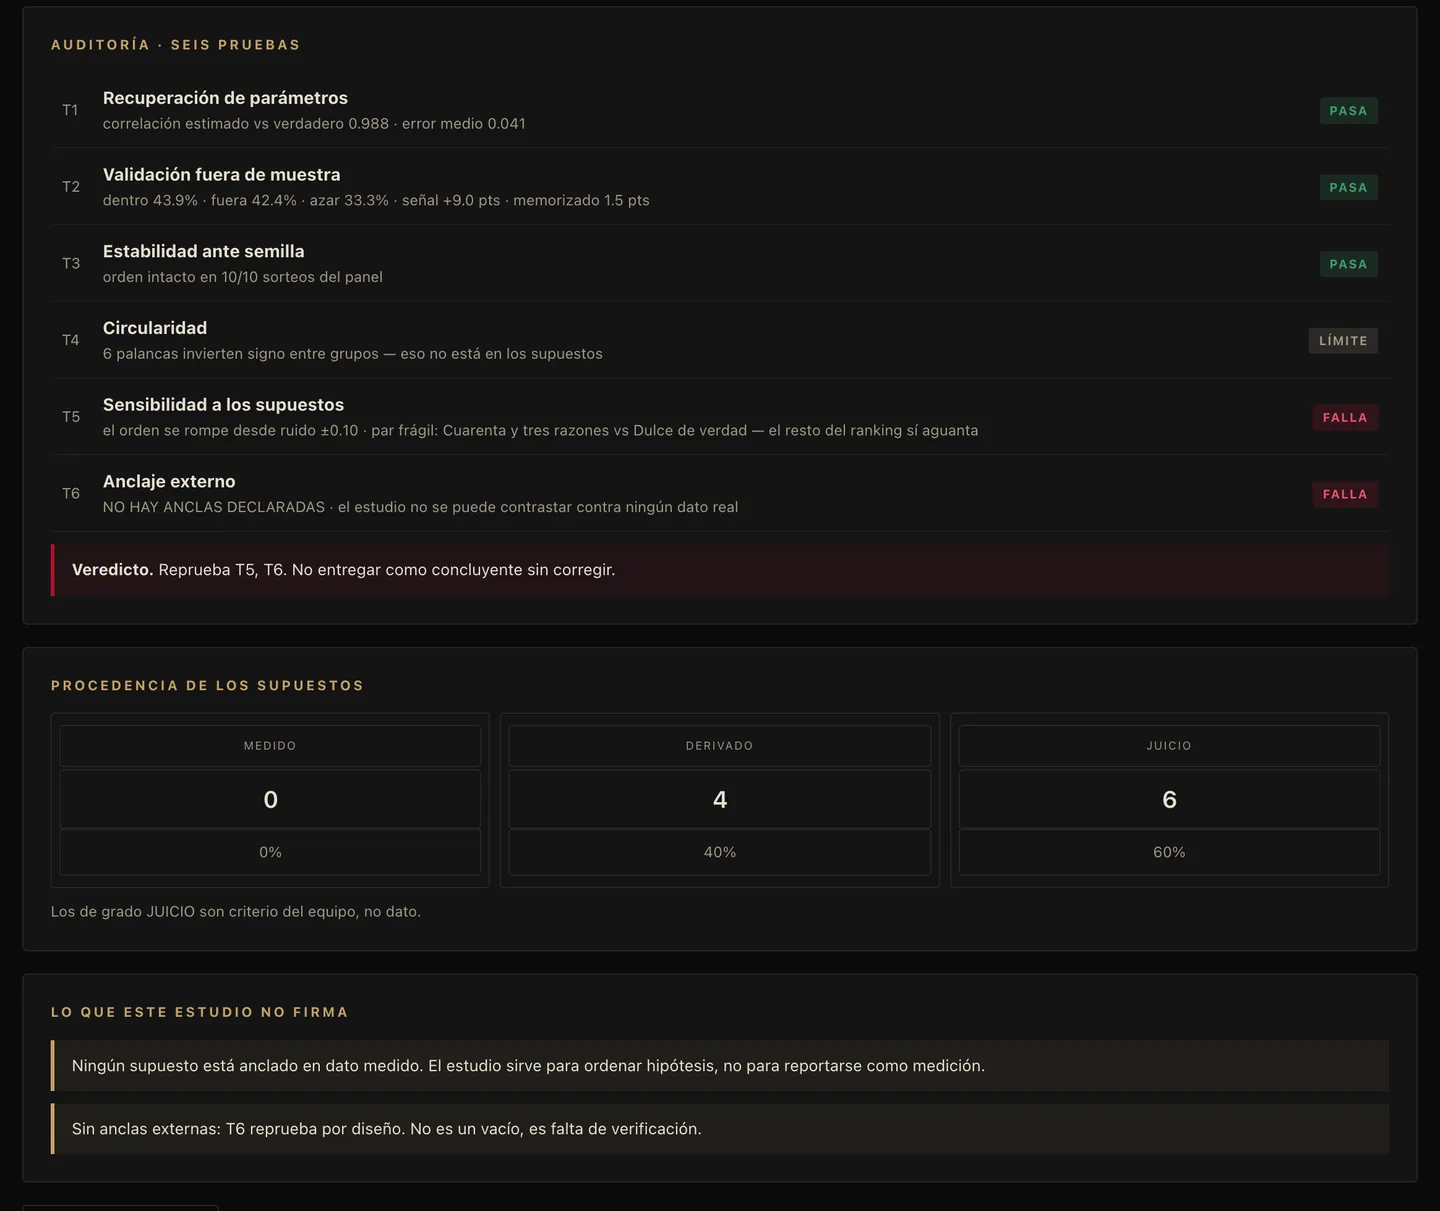
Y cada estudio se somete a seis pruebas y publica las que reprueba: recuperación de parámetros, validación fuera de muestra, estabilidad ante la semilla, circularidad, sensibilidad a los supuestos y anclaje externo. Una corrida de demostración reprobó dos y escribió sola «no entregar como concluyente sin corregir». Sin un dato externo contra el cual contrastar, el anclaje reprueba por diseño — y eso también se imprime.

Concept test
cuál de tus rutas creativas gana, con qué cohorte y por qué palanca
PSM · precios
en qué rango te dejan estar y en cuál ganas más
Cuali
con qué palabras lo dicen y qué objeción sale primero
Conjoint
qué palanca manda cuando hay que renunciar a algo

Para quién sirve, y con qué pregunta llega
Director de marca«¿cuál de estas tres rutas?»
Cuál gana, con qué cohorte y por qué palanca — con su intervalo de confianza. Y si las dos primeras quedan dentro del ruido, se lo dice en vez de coronar una.
Director creativo«¿me van a matar la idea?»
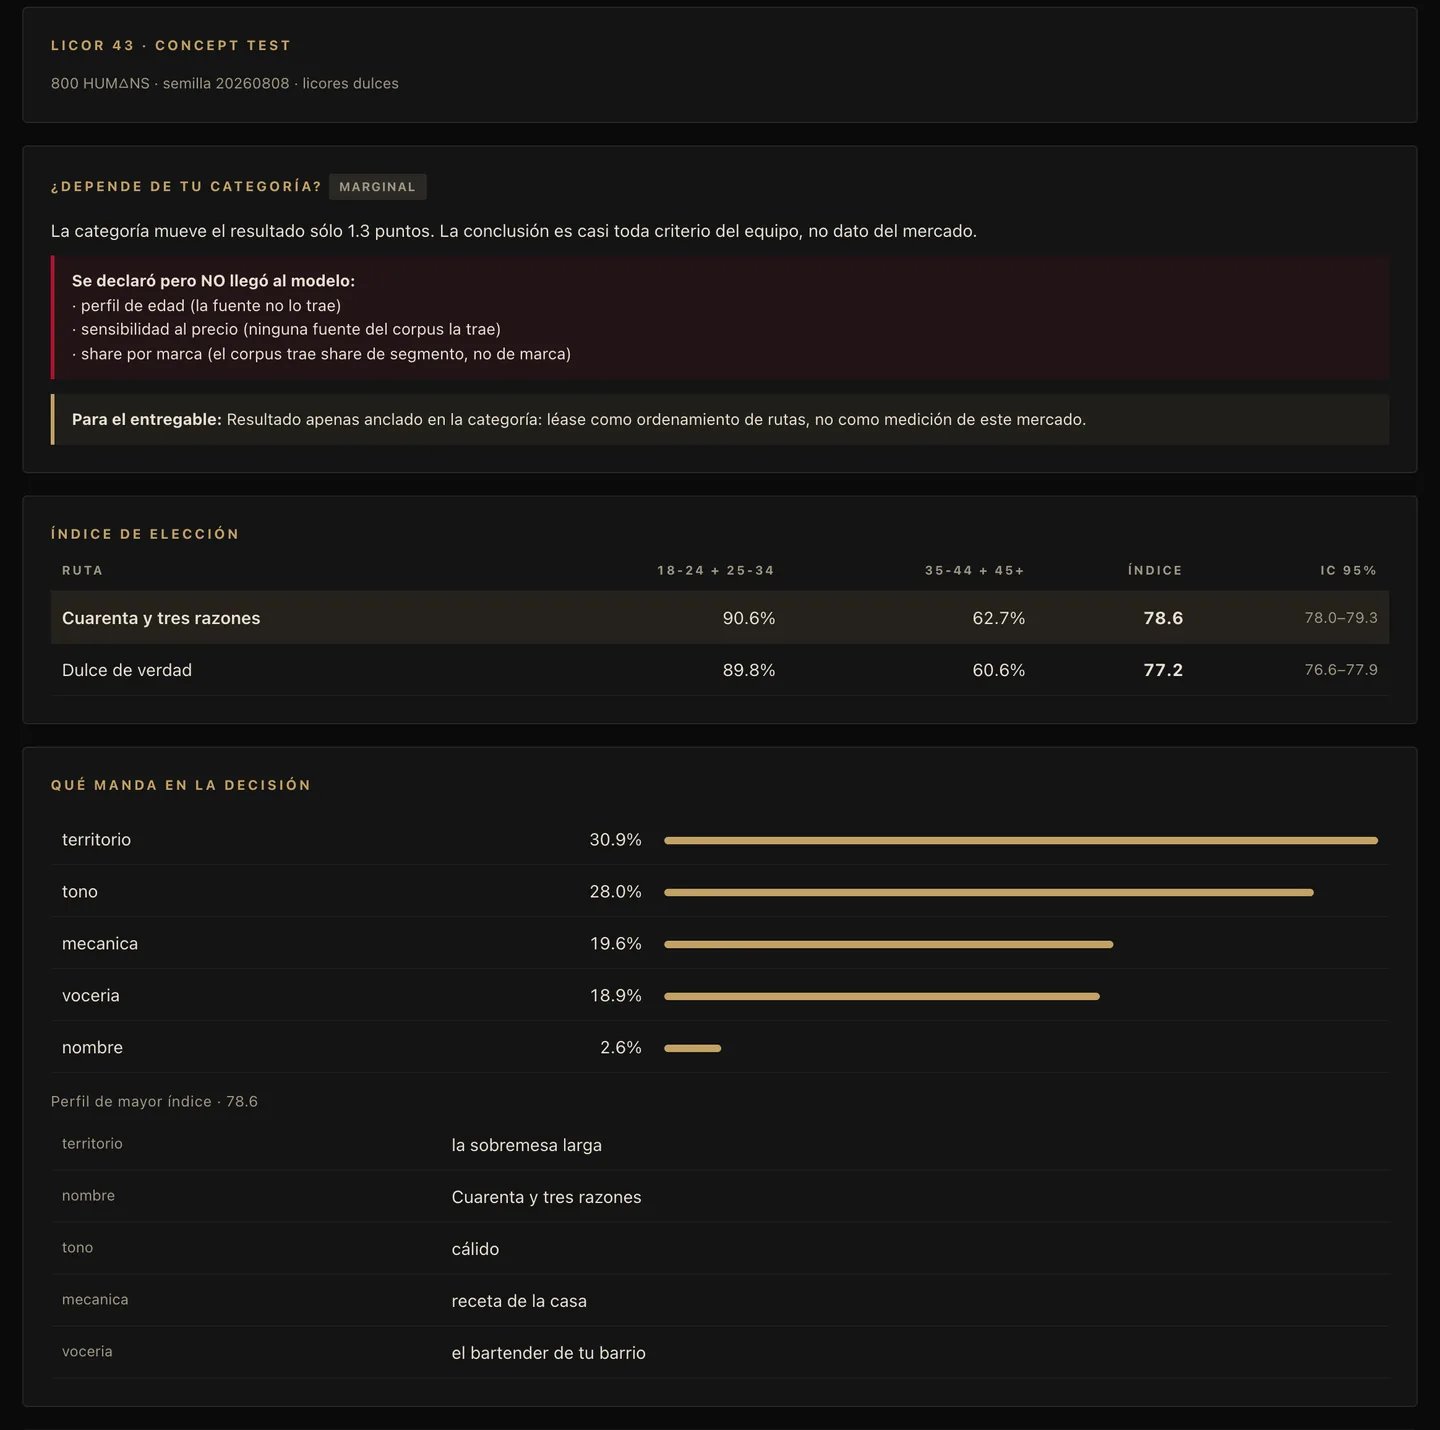
No. Le dice qué parte de la idea carga el peso: en una corrida real el territorio pesó 30.9% y el nombre 2.6%. Sirve para defender lo que importa y soltar lo que no.
Ventas / comercial«¿a qué precio me dejan estar?»
El rango en el que puede moverse y en cuál gana más, antes de probarlo en el mercado. Desde $15,000 y en cinco días hábiles.
Insights«¿esto es representativo?»
No, y lo imprime. Seis pruebas por estudio, las que reprueban se publican, y sin un dato externo contra el cual contrastar el reporte sale marcado «no calibrado». Ordena hipótesis antes de que usted pague campo; no sustituye el campo.
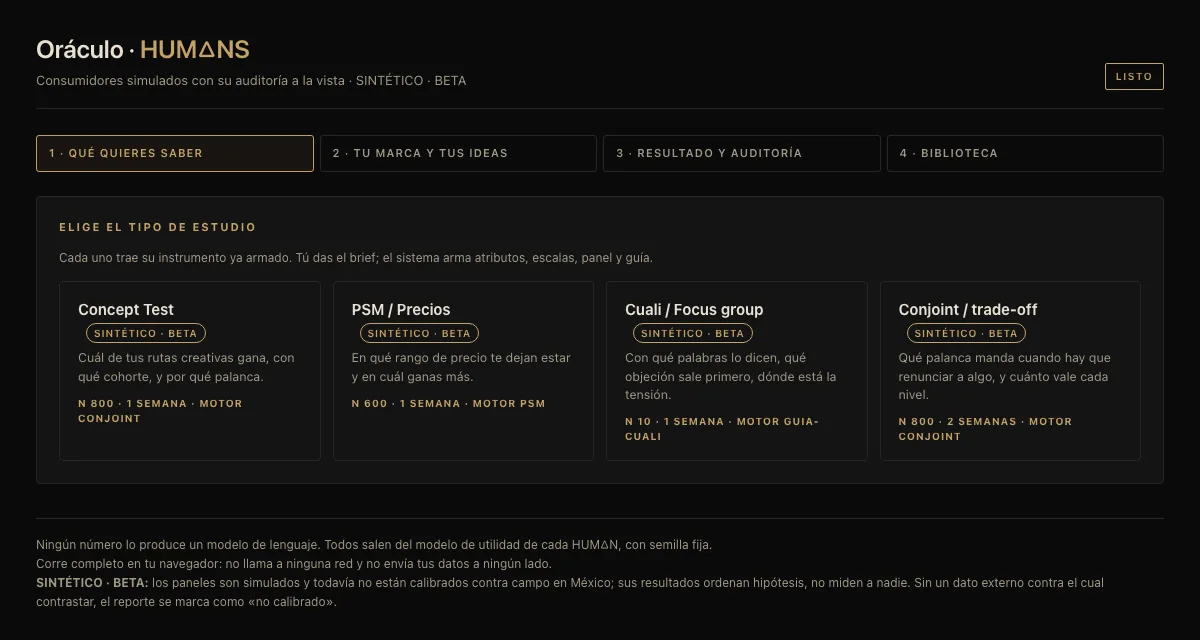
Pantalla de HUM△NS con sus cuatro instrumentos —Concept Test, PSM/Precios, Cuali y Conjoint— cada uno con su tamaño de panel y su plazo.
ALos cuatro instrumentos, ya armados. Cada uno con su tamaño de panel y su plazo — N 800 y una semana para concept test, N 600 para precios, N 10 para el cuali. Y en su propia pantalla, sin que haya que preguntarlo: «los paneles son simulados y todavía no están calibrados contra campo en México; ordenan hipótesis, no miden a nadie».
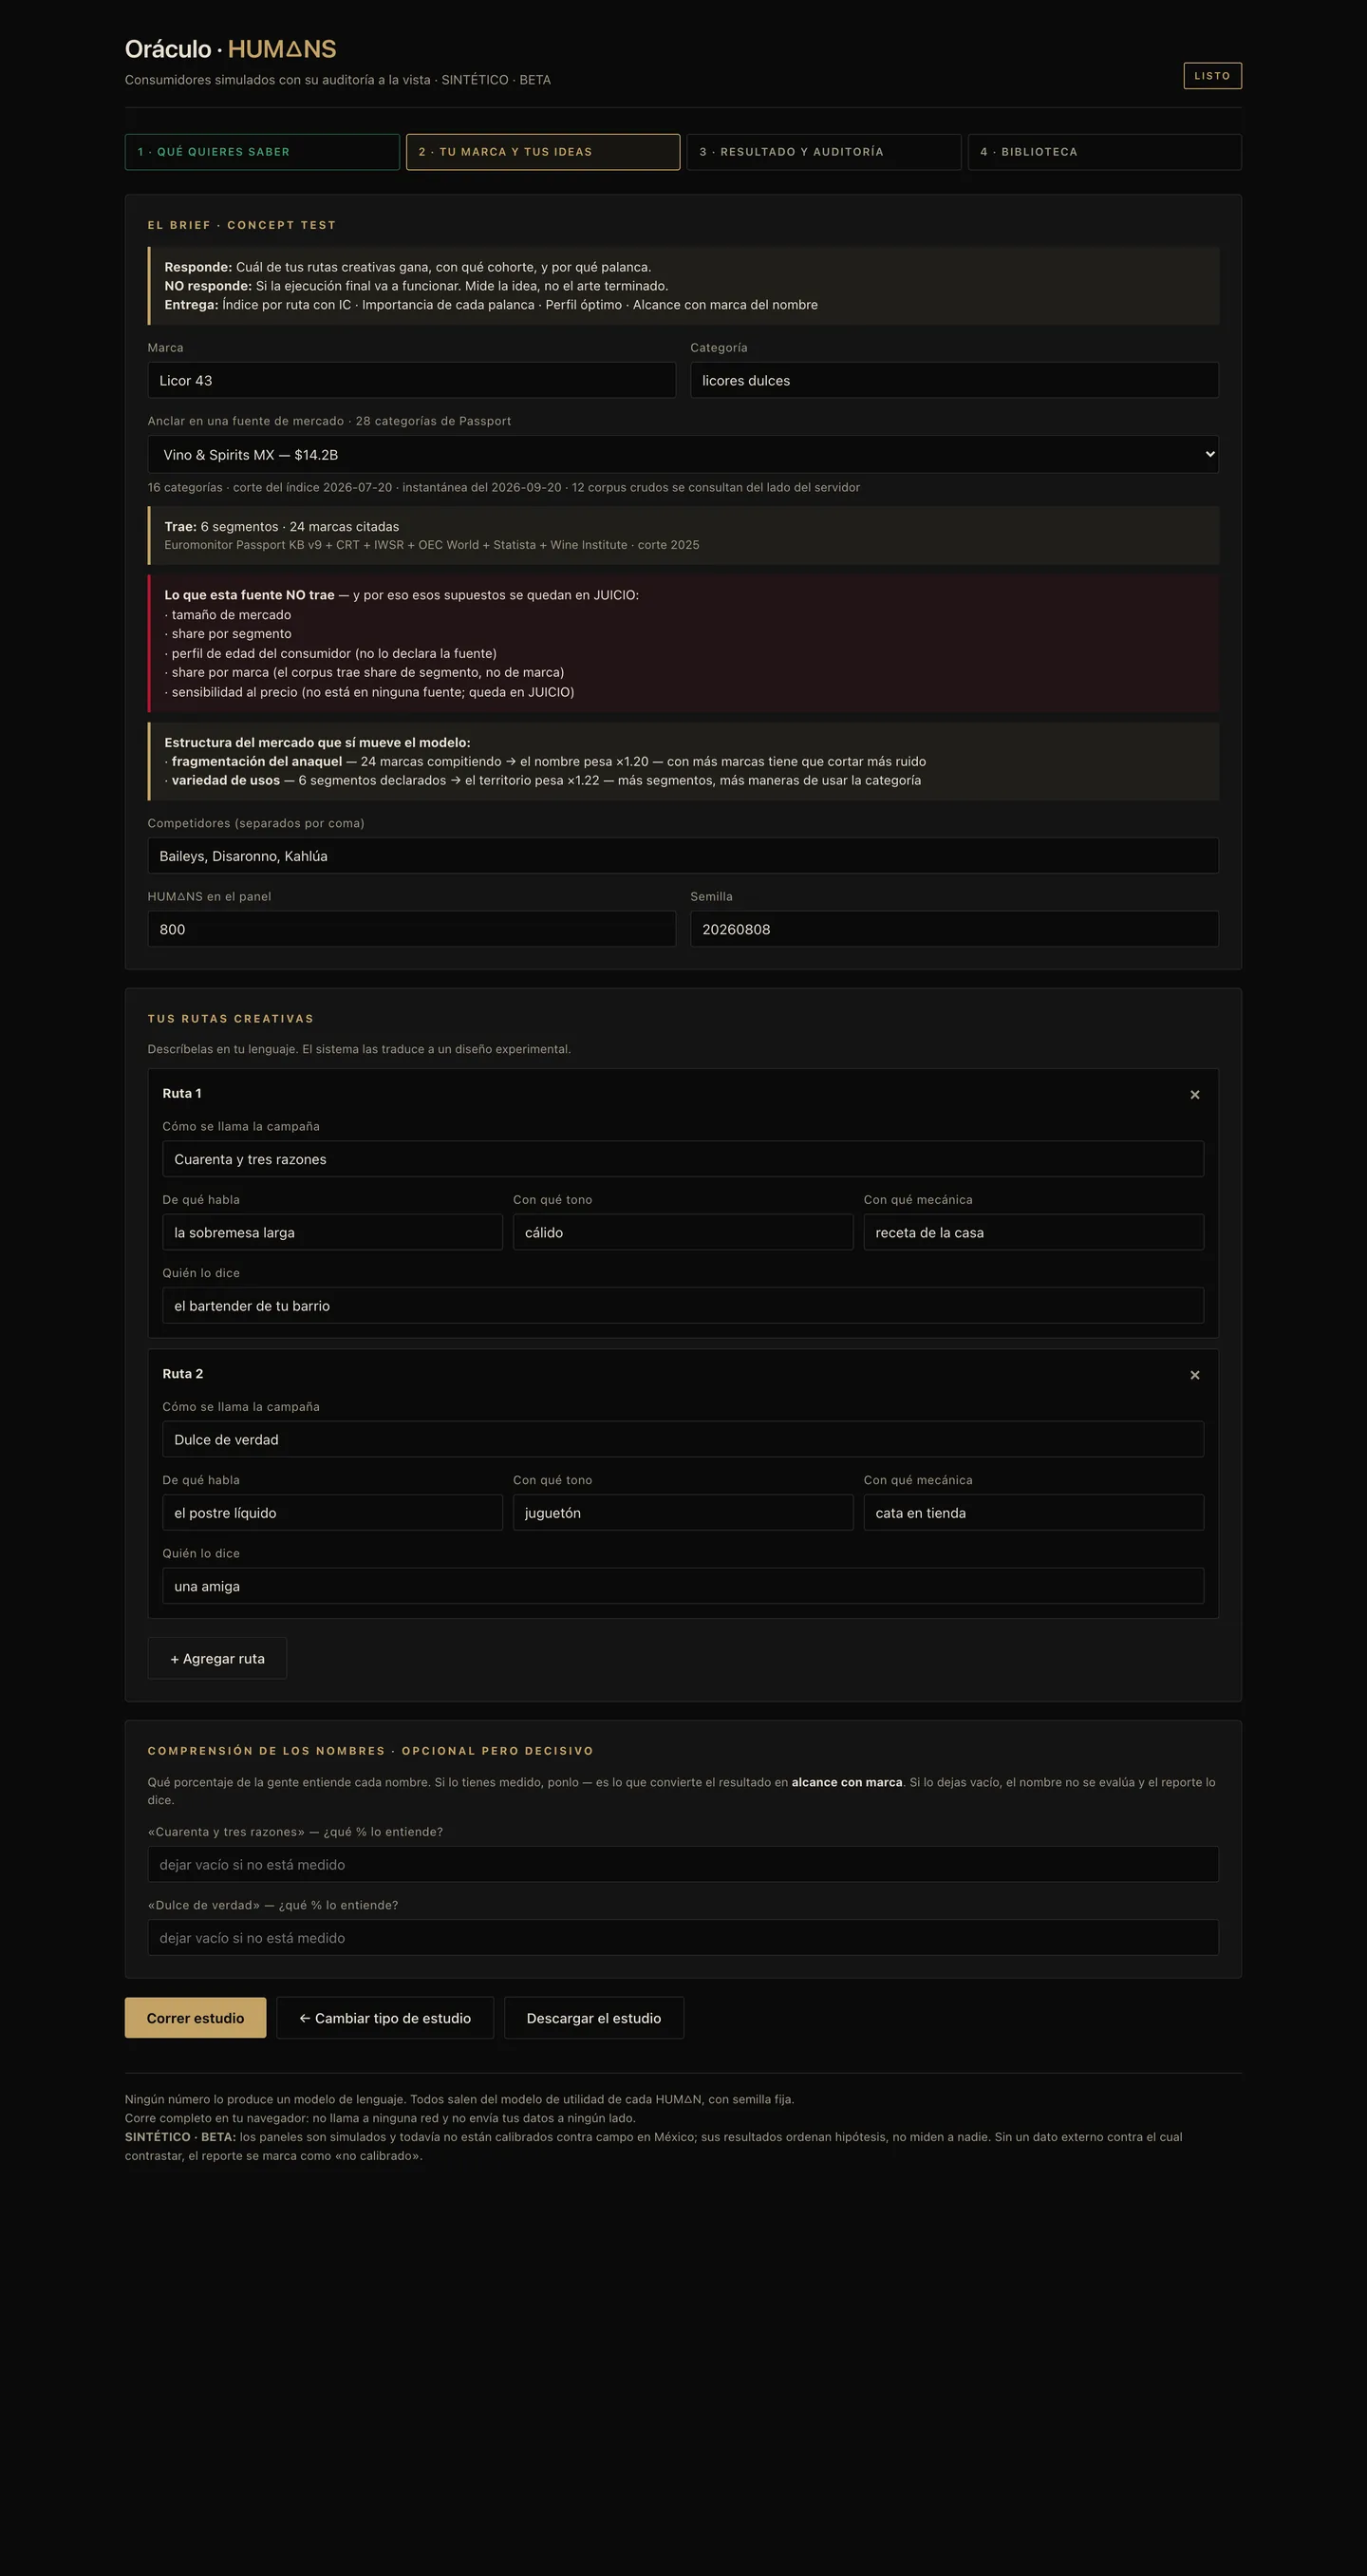
El brief de un concept test: marca, categoría, el desplegable para anclar en una fuente de mercado, competidores, tamaño del panel y semilla; debajo, las rutas creativas descritas en lenguaje del cliente.
BEl brief lo escribe usted en su idioma; el diseño experimental lo arma el sistema. Se describe cada ruta como se describe en una junta —de qué habla, con qué tono, con qué mecánica, quién lo dice— y el motor la traduce a atributos y niveles. Lo decisivo es el desplegable de arriba: anclar en una fuente de mercado o correr sin anclar, y en ese caso los supuestos quedan marcados como JUICIO. Hay 16 categorías para anclar, con su corte de índice a la vista.
Resultado de un concept test: índice de elección por ruta con su intervalo de confianza, el peso de cada palanca en la decisión, y arriba el aviso de que la categoría mueve el resultado sólo 1.3 puntos.
CEl resultado, y encima el aviso que lo acota. Dos rutas a 78.6 y 77.2 con su intervalo de confianza, y el reparto de lo que manda: territorio 30.9%, tono 28.0%, mecánica 19.6%, vocería 18.9% y el nombre apenas 2.6%. Pero antes de eso, en rojo: «la categoría mueve el resultado sólo 1.3 puntos; la conclusión es casi toda criterio del equipo, no dato del mercado», con la lista de lo que se declaró y no llegó al modelo —perfil de edad, sensibilidad al precio, share por marca— porque la fuente no los trae.
Auditoría de seis pruebas con su veredicto: T1, T2 y T3 pasan, T4 al límite, T5 y T6 fallan; debajo, la procedencia de los supuestos y el bloque «lo que este estudio no firma».
DY aquí es donde este producto se separa de todo lo demás. Cada estudio se somete a seis pruebas con nombre y publica el resultado de las seis. En esta corrida real: T1, T2 y T3 pasan; T4 queda al límite; T5 y T6 FALLAN. El veredicto lo escribe el propio sistema: «Reprueba T5, T6. No entregar como concluyente sin corregir.» Debajo, la procedencia —MEDIDO 0 · DERIVADO 4 · JUICIO 6— y el bloque «lo que este estudio no firma»: sin anclas externas, T6 reprueba por diseño; no es un vacío, es falta de verificación. Un proveedor que quiere cobrar no imprime esto.

Cómo se ve cuando corre: Caribe Cooler

RTD · México · agosto 2026 · semilla 20260808

La marca traía tres rutas de campaña y había que decidir cuál pagar: Bájale, Nos la llevamos cool y Soy tu Bias. Contra New Mix, Smirnoff Ice y Topo Chico Hard Seltzer.
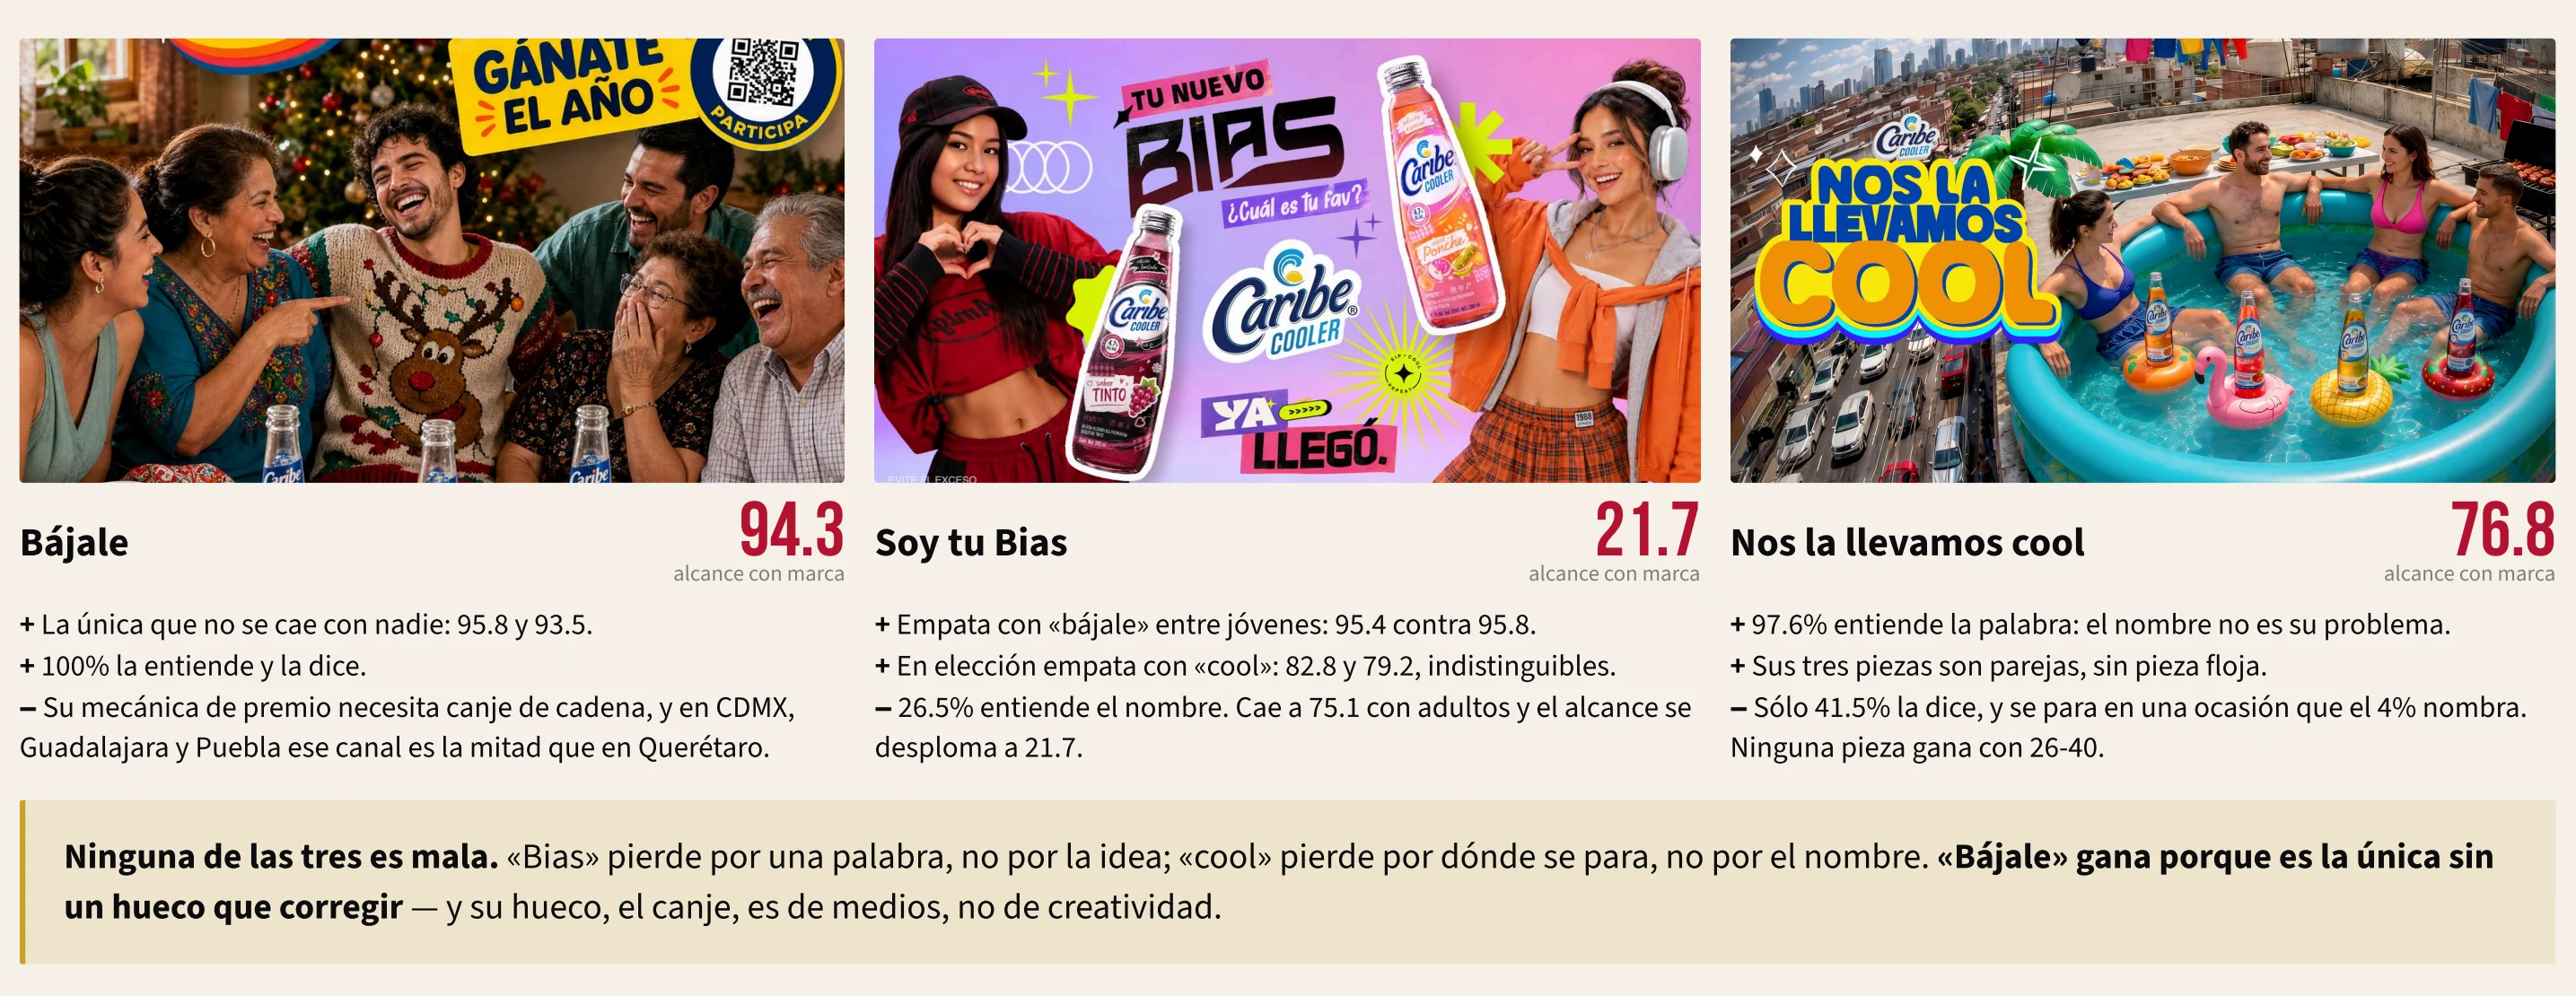
Las tres campañas de Caribe Cooler auditadas, cada una con su fotografía y su calificación de alcance con marca: Bájale 94.3, Soy tu Bias 21.7, Nos la llevamos cool 76.8
BLas tres, con su número. Las piezas reales de cada ruta, medidas una por una: Bájale 94.3 de alcance con marca, la campaña vigente Nos la llevamos cool 76.8, y Soy tu Bias 21.7, porque fuera de los jóvenes solo el 26.5% entendía el nombre. Ninguna de las tres es mala; una no tenía hueco que corregir.
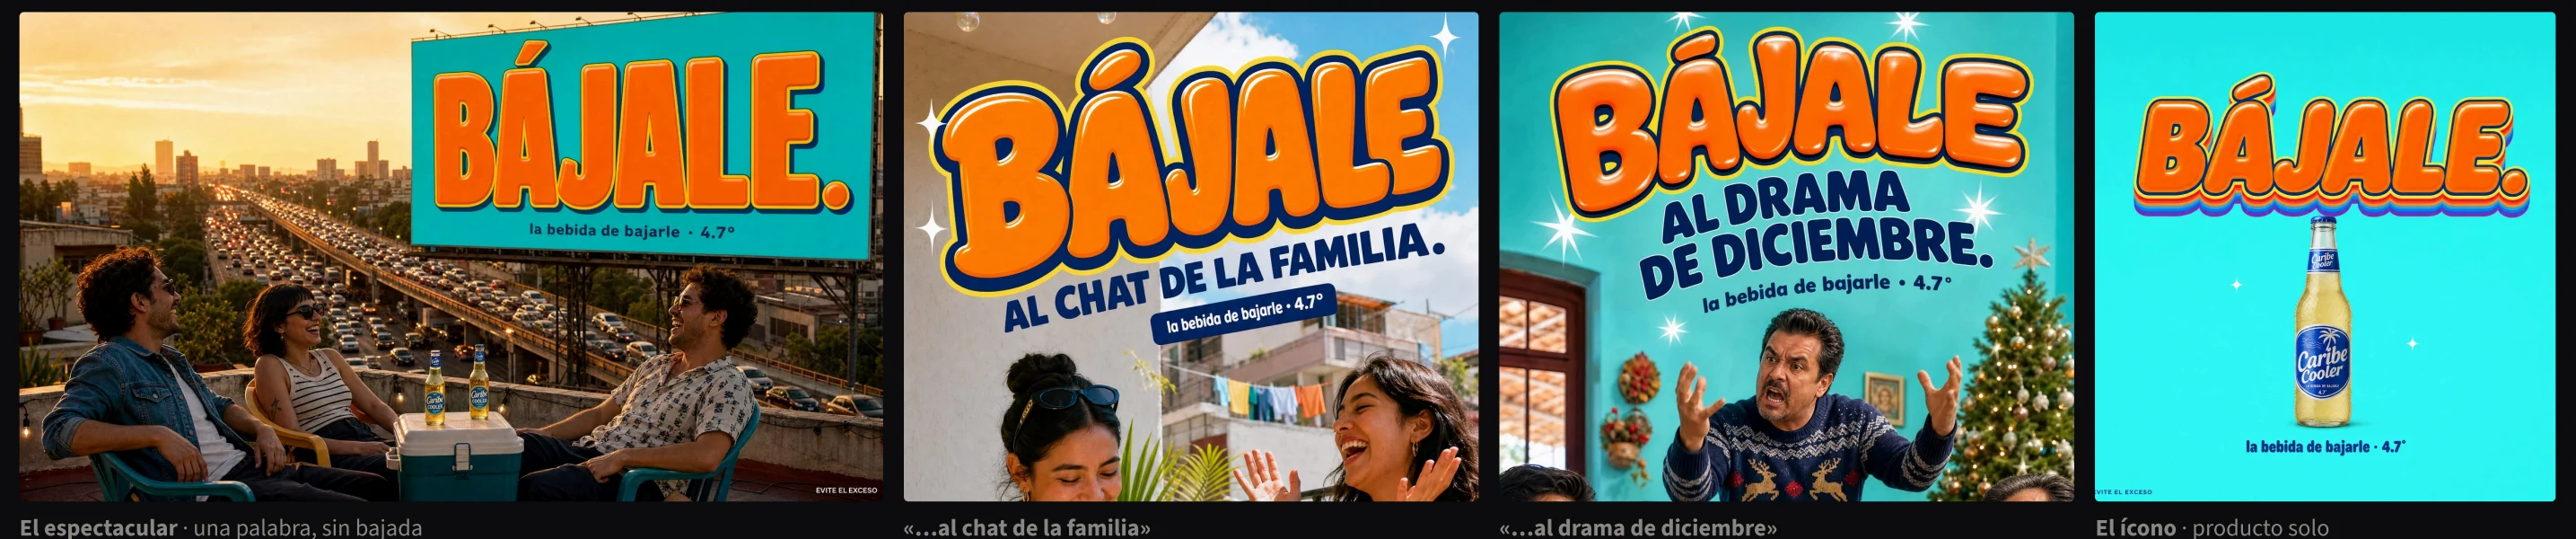
Las piezas de la ruta ganadora Bájale: espectacular, chat de la familia, drama de diciembre e ícono
CLa ruta que salió primero en simulación, pieza por pieza. Rotulación mexicana y un complemento que cambia: al chat de la familia, al drama de diciembre. Una campaña que solo tiene ejecuciones se acaba; una que tiene gramática, no. HUM△NS prioriza territorios creativos para investigación: ninguna ruta se declara ganadora sin validación humana o prueba de mercado.

Lo que se levantó

Panel
1,500 perfiles en cinco cohortes de 18 a 40, ponderadas, con tres rasgos modelados —juventud, fandom, nostalgia— y su desviación por cohorte
Conjoint
cinco atributos (territorio, nombre, tono, mecánica, vocería), 10 tareas, 3 alternativas, 400 repeticiones bootstrap y 10 semillas de auditoría
Grupo
800 personas, 166 intervenciones en siete tramos: apertura, calentamiento, cuerpo, estímulo, laddering, proyectiva y cierre
Control
una celda de comparación fija, para que el ganador se mida contra algo y no contra sí mismo

El hallazgo que cambió la decisión

La comprensión del nombre, medida cohorte por cohorte:

Bájaleimperativo del español cotidiano
100%
Nos la llevamos coolse entiende en todas las edades
96.6–98.8%
Soy tu Biasjerga de fandom coreano
41.2% → 14.8%

«Soy tu Bias» lo entiende el 41% de los de 18 a 25 y solo el 14.8% de los mayores de 26. Cinco de cada seis personas del grupo más grande de la categoría no sabrían de qué les hablan. Eso es una campaña nacional que se cae antes de comprarse, y se supo en una semana.

Lo que dijeron, con sus palabras

«Michelada, mezcal con algo, esas latas de vodka con sabor a fruta que ya andan de moda, un antro con luces bien feas, y el precio que se te suben en el súper sin razón.»

18–21 · calentamiento

«Que dejen de inventarle cosas a lo que ya está bueno, la neta. Si me sale buena una marca me quedo con ella, no necesito que me la cambien cada rato con puro rollo nuevo.»

26–30 · cierre

Y aquí el producto se corrige a sí mismo

El grupo se contrastó contra lo que la gente de verdad busca en internet sobre la marca. Seis temas quedaron ciegos y seis se indujeron solos:

Lo que el grupo nunca tocó y la gente sí pregunta
  • De qué está hecho50 búsquedas
  • Cuánto pega4 preguntas
  • Cómo se toma3
  • Quién la hace3
  • Efecto en el cuerpo3
  • A qué sabe2
Lo que el grupo trajo solo
  • Precio64 menciones
  • Ocasión de reunión58
  • Pertenencia / barrio44
  • «Suena falso»18
  • No entiende el nombre5
  • Suavidad5

No dice que el grupo esté mal. Dice que la guía no lo preguntó.

Ésa es la frase que el sistema escribe solo, y la consecuencia también: esos seis temas entran a la guía antes de volver a levantar cualitativo en la categoría. Una herramienta que solo confirma lo que le preguntas no sirve para decidir.

Hasta dónde llega el modelo, y dónde manda el dato

La comprensión de «bias» tiene un techo medido de 55.8% — lo que la gente busca no da para más. El modelo la ubica en 26.5%, que cabe debajo. El techo es dato; la posición dentro del techo es modelo, y las dos cosas van rotuladas por separado.

Con «bájale» pasa lo contrario: nadie busca qué significa. El techo queda en 100% y no restringe nada — y esa ausencia de búsquedas es evidencia conductual de que se entiende. Es la más barata que existe.

USD 0.60costó el grupo completo, 800 personas y 166 intervenciones
9 / 10de coherencia interna, verificada cohorte por cohorte
1 semanacontra las seis que tarda una encuesta de campo

Está en beta y lo dice el producto, no la letra chica

Sin un dato externo contra el cual contrastar, el reporte se marca como «no calibrado». Ningún número lo produce un modelo de lenguaje: todos salen del modelo de utilidad de cada perfil, con semilla fija — la misma pregunta da el mismo resultado.

Y si ya tienes algo listo

Mándame la campaña que estás a punto de pagar.

Antes de que el mercado te diga si funcionaba —cuando ya te cobró el error— te lo decimos nosotros. Y si no tenemos cómo medir tu categoría, también te lo decimos, sin cotización de por medio.